1.矩阵分解:特征值、SVD 与低秩近似
配套视频
B站 · 3B1B《线性代数的本质》第 14 集 · 特征向量与特征值 —— 先建立"有些方向变换后不变"的直觉
MIT · MIT 18.06 第 29 讲 · 奇异值分解 SVD —— 把 A = UΣVᵀ 讲成"旋转-拉伸-旋转"
⭐ 重点
特征向量:被矩阵变换后方向不变的那些向量;特征值是缩放倍数
SVD(奇异值分解):任何矩阵都能拆成 旋转 × 缩放 × 旋转,是矩阵分解的"万能工具"
奇异值从大到小排列:大的方向对矩阵能量贡献最大;小的方向是噪声,适合做数据来源判断
低秩近似:只保留前 k 个奇异值,可得到误差最小的秩 k 近似;是否值得存储取决于 k 是否足够小
大模型中的应用:低秩近似用于模型压缩与 embedding 降维,也为理解 LoRA 的低秩参数化提供数学基础
1.1 特征值与特征向量:变换中"不变的方向"
大多数向量被矩阵 A 作用后,方向会改变。但有那么几个特殊方向,方向不变,只是被拉长或压短:
特征值方程
v叫特征向量(eigenvector),λ叫特征值(eigenvalue)
💎 直觉:想象把一块橡皮膜按某个方向拉伸。膜上有几条"基准线"只被拉长、没被扭歪——那几条线就是特征向量,拉长的倍数就是特征值。
手算一个例子:求 A = [[2,1], [1,2]] 的特征值与特征向量:
第 1 步 · 写出特征方程(det(A − λI) = 0)
第 2 步 · 解出特征值
第 3 步 · 求 λ₁ = 3 的特征向量:代回 (A − 3I)𝐯 = 0
第 4 步 · 求 λ₂ = 1 的特征向量:同理
第 5 步 · 验证:
对称矩阵的好性质:如果 A 是对称的(A = Aᵀ),那么它一定能分解成 A = QΛQᵀ,其中 Q 的列是互相垂直的单位特征向量,Λ 是对角矩阵(对角线上是特征值)。这个性质叫谱分解,是 PCA 的理论基础。
1.2 SVD:任何矩阵都能拆开
特征值分解要求矩阵是方阵且可对角化。但大模型里的权重矩阵常常是长方形的(比如 4096×11008 的 FFN 层),这时候就要用 SVD(奇异值分解):
SVD —— 任意 m×n 矩阵都能这样拆
U:m×m 正交矩阵
Σ:m×n 对角矩阵(对角线上是奇异值 σ₁ ≥ σ₂ ≥ ⋯ ≥ 0)
V:n×n 正交矩阵
几何含义非常漂亮:任何线性变换 = 先旋转(Vᵀ)→ 再沿坐标轴缩放(Σ)→ 再旋转(U)。
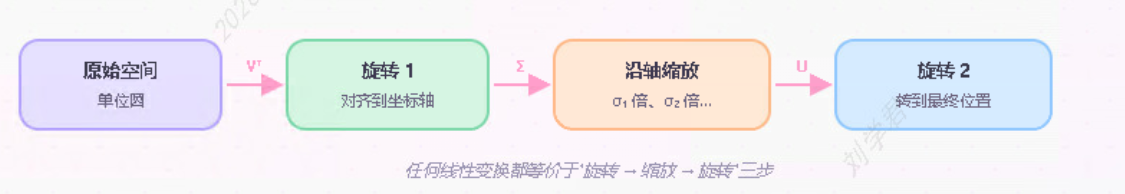
SVD 的几何含义——三步走完任意线性变换
1.3 低秩近似:为什么能"压缩"
SVD 最实用的性质之一是:如果一个矩阵的奇异值衰减得很快,少数几个方向就能集中它的大部分"能量"( \sum_k \sigma_k^2)。许多具有冗余结构的真实数据符合这一特征,但并非所有矩阵都如此。
于是我们可以只保留前 k 个奇异值,得到原矩阵的一个近似:
截断 SVD(低秩近似)
(只取前 k 列 / 前 k 个奇异值) 存储量: m \times n \;\rightarrow\; k(m+n+1)
⭐ 从低秩近似到 LoRA
低秩分解说明,一个秩为 r 的矩阵可以写成两个小矩阵的乘积。LoRA 借用这种参数化:微调时冻结原权重 W₀,只学习一个增量 ΔW,并假设完成下游任务所需的更新具有较低的内秩:
其中 B 是 d×r、A 是 r×d,r 通常取 8 / 16 / 32。对一个 d×d 权重,参数量从 d² 降到 2dr,d=4096、r=8 时,该层增量的可训练参数约为原权重的 0.39%。注意:LoRA 通常不是先对 ΔW 做 SVD,也不要求原权重 W₀ 本身是低秩矩阵;"任务所需的权重更新可用低秩形式有效表示"才是关键假设。
1.4 在大模型里的应用
代码:用 SVD 压缩一张图,亲眼看到"低秩近似"的效果
1⚠️ 常见混淆点:
① 特征值 vs 奇异值:特征值只对方阵有定义、可正可负;奇异值对任何矩阵都有定义、永远非负。
② 特征值分解 vs SVD:只有可对角化的方阵才能写成 A = QAQ⁻¹;实对称矩阵还有更好的形式 A = QΛQᵀ。任意 m×n 矩阵都存在 SVD(A = UΣVᵀ)。
③ 低秩 vs 有效低秩:加噪矩阵通常是满秩的,但如果只有少数奇异值显著较大,仍可说它具有较低的"有效秩"。
评论区